Qué es platform engineering
Platform engineering es una disciplina sociotécnica: diseña, construye y mantiene una plataforma interna de desarrollo (IDP, por sus siglas en inglés) que los equipos usan para llevar su software a producción. Es «socio» porque no va solo de herramientas: va de cómo trabajan juntos quienes construyen la plataforma y quienes la usan.
El objetivo es simple de enunciar: que desplegar una aplicación bien, con seguridad y con control de coste, sea también lo más fácil de hacer.
Los cuatro conceptos que lo sostienen
La plataforma como producto. El equipo de plataforma trata a los desarrolladores como sus clientes: escucha qué les frena, prioriza, mide si la usan y la mejora. Una plataforma que nadie adopta no ha resuelto nada.
Caminos pavimentados (golden paths). Flujos con criterio propio y soportados: del repositorio a producción con pocos pasos, con pruebas, escaneo y despliegue por GitOps ya resueltos. Quien se sale del camino puede hacerlo, pero asume lo que eso implica.
Autoservicio. Un equipo puede pedir un entorno, una pipeline o un espacio en el clúster sin abrir un ticket y esperar. Las reglas (cuotas, políticas, etiquetas) van incluidas en la plantilla, no en una revisión manual.
Menos carga cognitiva. La plataforma esconde la complejidad de la infraestructura, de Kubernetes y de las políticas de seguridad, para que el equipo piense en su producto y no en cómo se configura un ingress.
Qué pasa cuando un equipo de desarrollo no lo tiene
No es un fallo de Kubernetes (si ya lo operas, mira cómo interpretar alertas y métricas sin sobresaltos): es lo que ocurre cuando se adopta la herramienta sin diseñar cómo se va a usar. Son patrones habituales, no datos de un cliente concreto:
Cada equipo despliega a su manera. Scripts, kubectl a mano, Helm sin convención. Un despliegue depende de quién lo haga y quién esté de vacaciones.
Los entornos se multiplican y no se apagan. Dev, test y staging funcionan las 24 horas del día aunque se usen en horario laboral, y nadie es dueño de apagarlos.
Un equipo afecta a otro. Sin cuotas ni límites, una carga descontrolada agota los nodos que comparten todos.
El coste es opaco. La factura llega por cuenta o suscripción, no por equipo ni por servicio, y nadie sabe responder «¿cuánto cuesta el equipo X?».
La seguridad se improvisa. Credenciales de larga duración en la integración continua, contenedores como root, permisos de administrador repartidos. Aquí ayudan 5 controles DevSecOps por los que empezar.
Todo pasa por una persona. Los desarrolladores esperan a «el que sabe de Kubernetes», que se convierte en cuello de botella y en riesgo de continuidad.
Qué ganas al tenerlo
Los beneficios son cualitativos y se pueden comprobar en cada equipo. No prometemos porcentajes: dependen de dónde partas.
Entrega más fluida: los equipos despliegan sin depender de una sola persona, con el mismo camino y las mismas comprobaciones.
Coste visible: con etiquetado y reparto por equipo, el gasto deja de ser una cifra global y pasa a tener responsables.
Seguridad por defecto: políticas de pods, red cerrada por defecto, identidad de carga de trabajo sin claves estáticas y secretos en el almacén de la nube, aplicados por la plantilla y no por la memoria de cada equipo.
Incorporación más rápida: un equipo nuevo parte de una guía y de plantillas, no de cero.
Menos dependencia de personas concretas: el conocimiento vive en la plataforma y en su documentación.
Producción y no producción: misma plataforma, distintas reglas
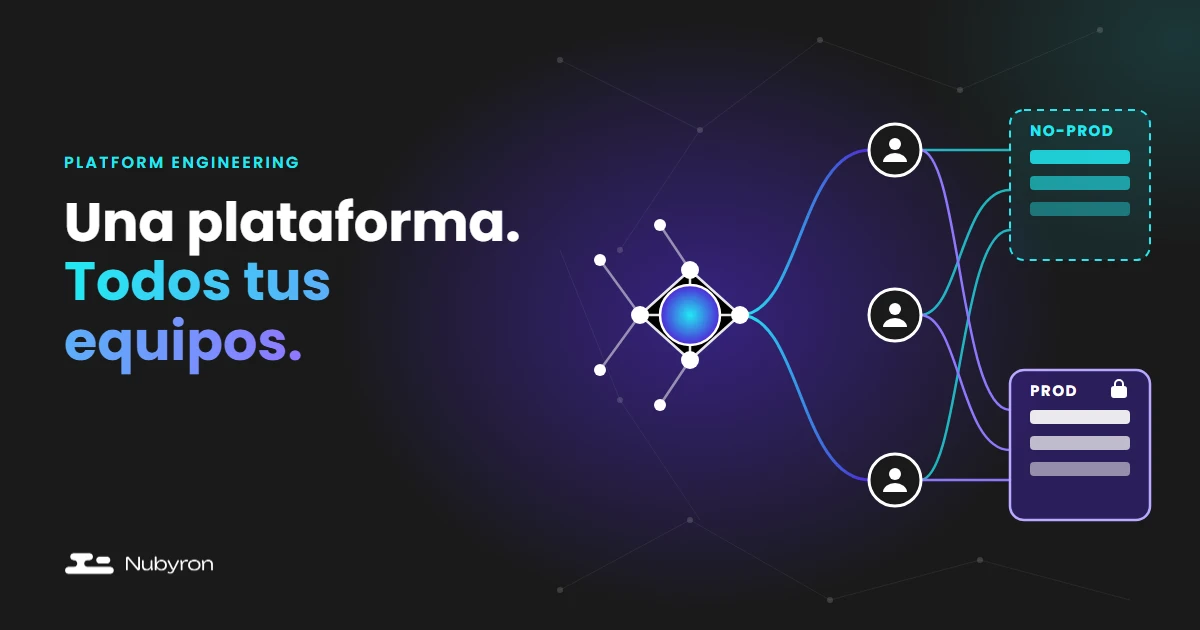
Una plataforma bien diseñada no trata igual todos los entornos. El aislamiento se aplica a nivel de cuenta, suscripción, proyecto o compartimento (según la nube), porque ahí se fijan los límites de identidad, red y reparto de costes, no solo en el clúster.
En producción: espacio propio, despliegue con aprobación y un rol específico, y datos reales. En no producción (desarrollo, pruebas y staging): infraestructura compartida entre entornos, despliegue automático y datos sintéticos o anonimizados; nunca copias de datos de clientes.
Dos piezas ayudan mucho. Los entornos efímeros crean un entorno por cada cambio propuesto y lo destruyen solos al terminar. Y un staging realista mantiene la misma versión de Kubernetes y las mismas políticas que producción, con menos capacidad y la posibilidad de apagarlo cuando no se usa. La misma imagen se promueve entre entornos; solo cambia la configuración.
Varios equipos sin que la factura se dispare
Dar a cada equipo su propio clúster es la forma más sencilla de aislarlos y también la más cara: cada clúster suma capacidad base, trabajo de operación y, según la nube y el nivel de servicio, cargos fijos del plano de control. La regla práctica es pagar solo el aislamiento que cubra el riesgo real.
Un punto de partida habitual, que se valida en cada caso, es un clúster de producción y otro de no producción, con un espacio por equipo y cuotas. Se reserva el clúster dedicado para requisitos regulatorios o riesgos que lo justifiquen, y los clústeres virtuales para pruebas que necesiten su propia API.
Las palancas de coste más comunes son apagar el no producción fuera de horario, usar capacidad interrumpible (spot; preemptible en OCI) en cargas que toleren interrupciones, activar el autoscaling de nodos, ajustar las peticiones y los límites de recursos al uso real, poner caducidad a los entornos efímeros y repartir el coste por equipo con etiquetado y herramientas como OpenCost (ver optimización de costes cloud).
Una precisión importante: todo esto es ahorro potencial. El ahorro real solo existe cuando se mide antes y después, así que conviene diseñar la medición desde el principio.
Cuándo no hace falta y cómo empezar
Platform engineering no es obligatorio ni gratis: una plataforma sin propietario envejece, y un camino demasiado ambicioso no se adopta. Con pocas aplicaciones, sin nadie que pueda ser dueño de la plataforma o con necesidades simples, servicios gestionados como ECS/Fargate, Azure Container Apps, Cloud Run o App Service pueden bastar con menos operación. Y Kubernetes tampoco es la única base posible para una plataforma interna.
Para empezar, mejor pequeño: elige un camino de despliegue y un tipo de aplicación, automatiza lo que más duele, etiqueta desde el primer día y mide si los equipos lo usan. Después amplía. En Nubyron diseñamos este tipo de plataformas, con Kubernetes como centro (Kubernetes y DevOps), para entornos productivos y no productivos en AWS, Azure, Google Cloud y OCI, y entregamos la arquitectura, el código de referencia y las guías para que tus equipos la operen.
Preguntas frecuentes
¿Qué es una plataforma interna de desarrollo (IDP)?
Es el conjunto de herramientas, plantillas y automatizaciones que un equipo de plataforma ofrece a los desarrolladores para crear entornos, desplegar y operar sus aplicaciones de forma estandarizada y en autoservicio.
¿Hace falta Kubernetes para hacer platform engineering?
No necesariamente. Kubernetes es una base habitual cuando hay muchos equipos y servicios, pero con pocas aplicaciones pueden bastar servicios gestionados más sencillos. Se decide por el caso, no por moda.
¿Cómo se evita que los entornos de varios equipos disparen el coste?
Compartiendo infraestructura de no producción con espacios y cuotas por equipo, apagando lo que no se usa, usando capacidad interrumpible en cargas que toleren interrupciones, ajustando recursos al uso real y repartiendo el coste por equipo. Es ahorro potencial hasta que se mide.
¿Qué diferencia hay entre platform engineering y DevOps?
DevOps es una cultura y un conjunto de prácticas para que desarrollo y operaciones colaboren. Platform engineering las concreta en un producto interno: una plataforma con caminos pavimentados y autoservicio que reduce la carga cognitiva de los equipos. No se excluyen: la plataforma es una forma de aplicar DevOps a escala.
¿Cuándo compensa montar una plataforma interna de desarrollo?
Cuando varios equipos despliegan a su manera, los entornos se multiplican, el coste no se reparte por equipo o todo depende de una persona. Con pocas aplicaciones y poco personal, suele bastar un servicio gestionado más sencillo.
¿Quieres una plataforma para que tus equipos desplieguen solos?
Diseñamos plataformas Kubernetes para equipos de desarrollo, en producción y en pruebas, compartiendo infraestructura con el coste a la vista.
Podemos revisar tu caso contigo en una conversación de 30 minutos y decirte si tiene sentido, o si te basta algo más sencillo.
Hablar con Nubyron